
主题
如何使用 API
如果你想在服务器上通过 API 调用大语言模型,进行文字对话、图片理解或 PDF 内容处理,请查看对应的接口文档:
- 接入 GPT 全系大语言模型,请看 GPT 对话补全 API。
- 接入 Claude 全系大语言模型,请看 Claude 消息 API。
如果你想让 AI Agent 帮你生成图像或视频,可以把下面的提示词直接发给它。Agent 会向你索取模型文档链接和 API Key,再按 ClawPower 文档完成调用;你无需自己研究各模型的接口细节。
前提
本页默认你已经具备以下条件:
- 已创建 ClawPower API Key。
分组必须选对
在使用前把 Key 的分组选为「图像视频精选」。
如果没有 Key,下方是常用入口,按需跳转即可:
API 端点
所有 ClawPower 模型的接口都发往 https://api.clawpowerai.com,不同模型用不同路径区分;具体路径写在下面示例里 Agent 要去读的模型文档里。
示例 1:教会 Agent 生成图像
复制下面的提示词,原文发送给你的 Agent,不需要做任何修改:
text
请帮我接入 ClawPower 的图像生成模型,并按下面的流程工作:

1. 先向我要两项信息,收齐之前不要开始生成:
   - 我要使用的图像模型的 ClawPower API 文档完整链接(链接内容里已经写了模型名、接口、参数,不用再额外告诉我模型叫什么)
   - 我的 ClawPower API Key(分组必须为「图像视频精选」)
2. 打开我提供的 API 文档链接,阅读并掌握该模型的接口地址、认证方式、请求参数和响应格式,一切以文档为准;同步生图请求的客户端读取超时统一设为 480 秒,并在创建可复用 Skill 时保存这个设置。
3. 信息收齐后,向我要「想要生成的画面描述」,调用接口完成生图并把图像发给我。整个过程一气呵成,不要中途停下来问我「要不要继续」「是否要等」之类的话——我只需要在最后收到图像(或一条失败原因)。
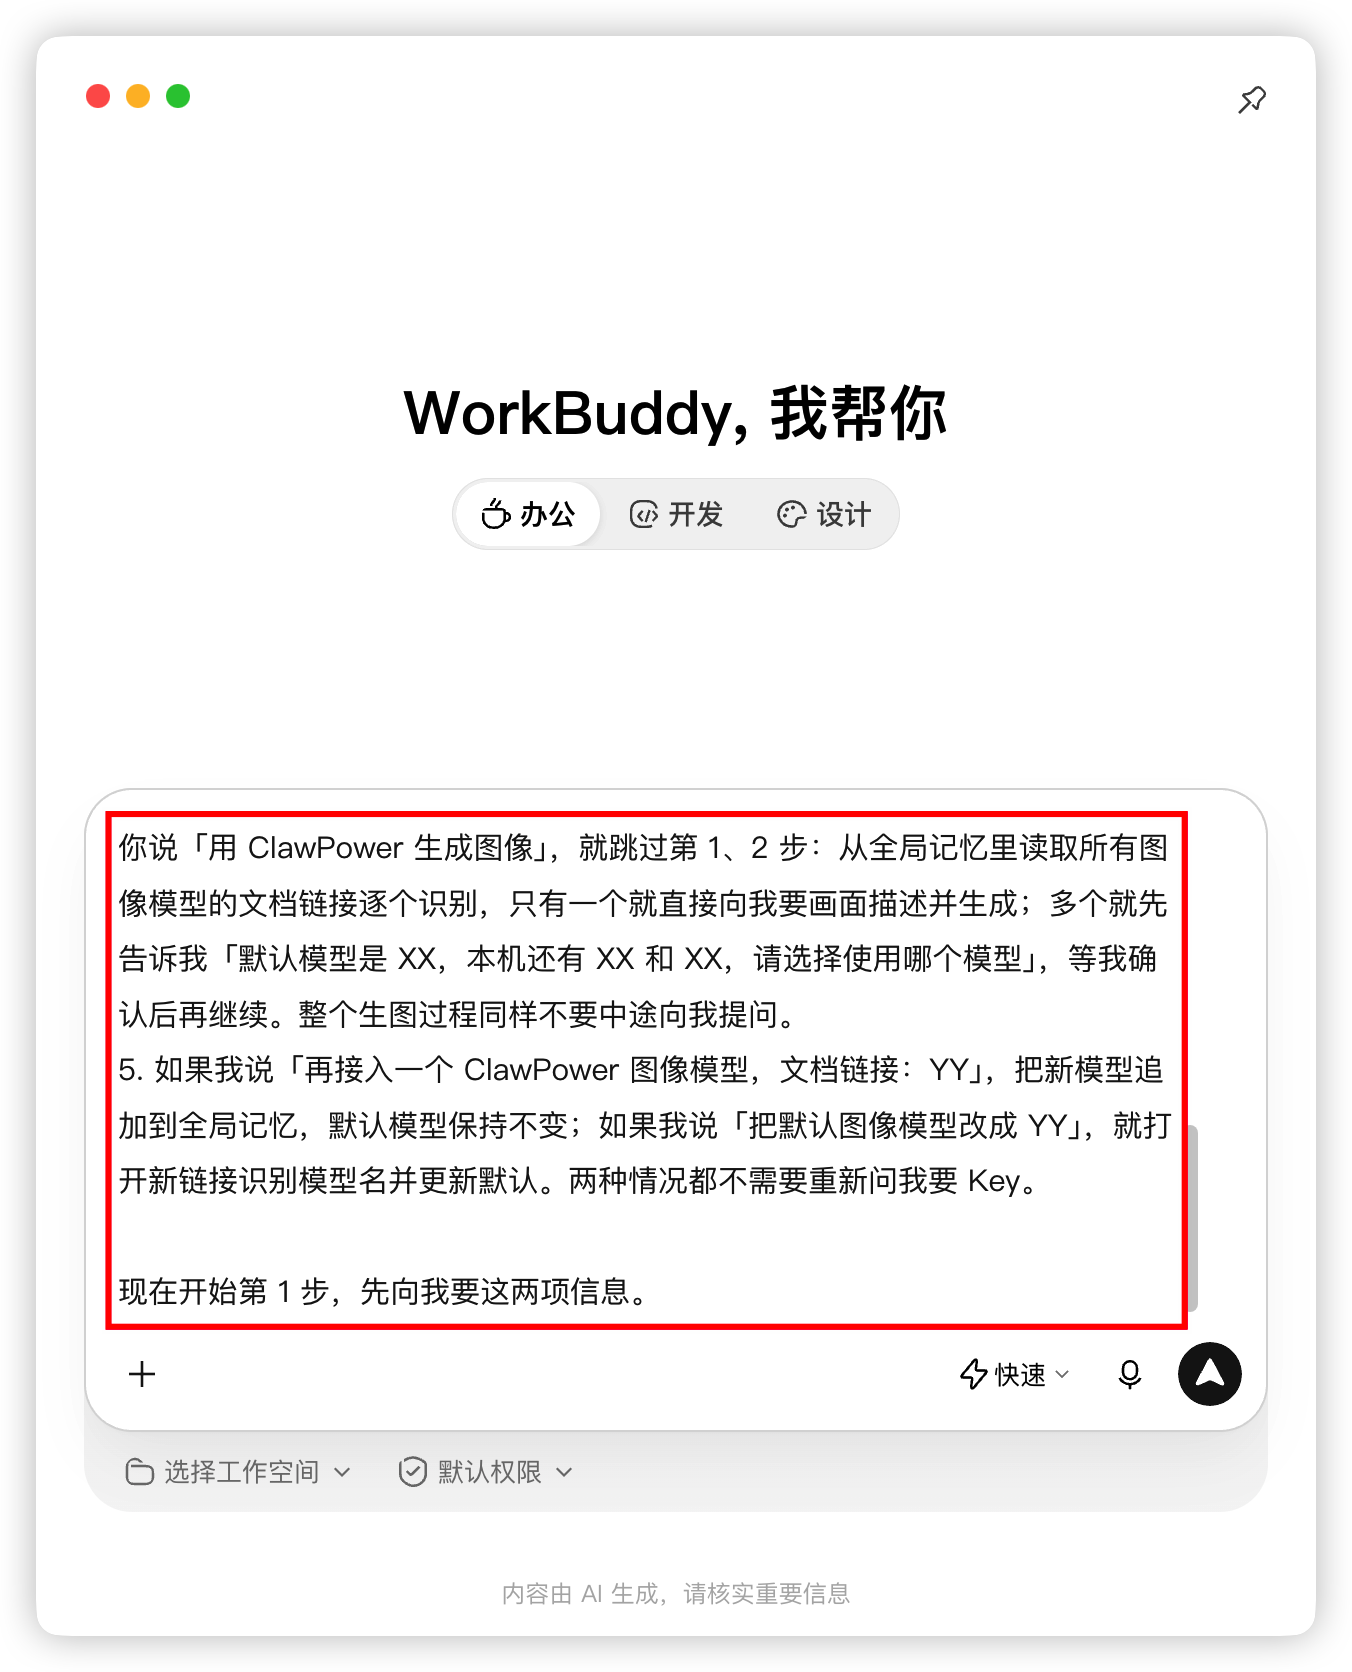
4. 把第 1、2 步拿到的文档链接与 Key 写入你的全局记忆(用户级配置文件,而不是只属于当前项目的记忆),并将该模型设为默认图像模型。之后只要我对你说「用 ClawPower 生成图像」,就跳过第 1、2 步:从全局记忆里读取所有图像模型的文档链接逐个识别,只有一个就直接向我要画面描述并生成;多个就先告诉我「默认模型是 XX,本机还有 XX 和 XX,请选择使用哪个模型」,等我确认后再继续。整个生图过程同样不要中途向我提问。
5. 如果我说「再接入一个 ClawPower 图像模型,文档链接:YY」,把新模型追加到全局记忆,默认模型保持不变;如果我说「把默认图像模型改成 YY」,就打开新链接识别模型名并更新默认。两种情况都不需要重新问我要 Key。

现在开始第 1 步,先向我要这两项信息。
发送后 Agent 会先向你要两样东西:
- 文档链接:在下表选择要用的模型,点右侧「复制」按钮,将完整 URL 发给 Agent。其他模型的文档可从左侧「图像模型」菜单打开。
- Key:把「图像视频精选」分组下的 Key 发给它。
| 文档地址(点右侧按钮一键复制完整链接) |
|---|
两项都给它之后,它会向你要画面描述,然后开始生图。
示例 2:教会 Agent 生成视频
复制下面的提示词,原文发送给你的 Agent,不需要做任何修改:
text
请帮我接入 ClawPower 的视频生成模型,并按下面的流程工作:

1. 先向我要两项信息,收齐之前不要开始生成:
   - 我要使用的视频模型的 ClawPower API 文档完整链接(链接内容里已经写了模型名、接口、参数,不用再额外告诉我模型叫什么)
   - 我的 ClawPower API Key(分组必须为「图像视频精选」)
2. 打开我提供的 API 文档链接,阅读并掌握该模型的接口地址、认证方式、请求参数和响应格式,一切以文档为准;视频模型通常需要你额外阅读 ClawPower 的「查询视频任务」文档(https://docs.clawpowerai.com/api/tasks/query-video-task ),因为视频生成是异步的,提交任务后必须通过该接口轮询获取视频 URL 再下载。如果生成请求包含本地图像、视频或音频,先按素材类型分别调用 ClawPower 的上传图像(https://docs.clawpowerai.com/api/uploads/upload-image )、上传视频(https://docs.clawpowerai.com/api/uploads/upload-video )或上传音频(https://docs.clawpowerai.com/api/uploads/upload-audio )接口,取得返回的公网 URL 后再填入模型请求的对应字段;每个文件分别上传,不要把本地路径、file:// 地址或 Base64 直接填入只接受公网 URL 的字段。
3. 信息收齐后,向我要「想要生成的视频描述」,并询问是否有要使用的参考图像、参考视频或参考音频;没有参考素材就直接按文生视频处理,有参考素材就先按第 2 步上传本地文件并根据模型文档选择正确字段。然后提交生成任务 → 用「查询视频任务」接口按文档建议的轮询节奏(间隔与最大次数以文档为准)持续查询 → 直到视频可下载 → 拿到视频文件 URL 后下载 → 把视频发给我。整个过程一气呵成:只在提交成功后简短告知我一次「已提交,任务 ID:xxx,正在生成」(只是为了让我知道开始干了,不是请求我确认),然后就不要再问我任何话、不要把每一次轮询的 status 念给我听;轮询达到最大次数仍不成功时再把失败信息与原因一次性告诉我。视频模型同理,我只需要在最后收到视频(或一条失败原因)。
4. 把第 1、2 步拿到的文档链接与 Key 写入你的全局记忆(用户级配置文件,而不是只属于当前项目的记忆),并将该模型设为默认视频模型。之后只要我对你说「用 ClawPower 生成视频」,就跳过第 1、2 步:从全局记忆里读取所有视频模型的文档链接逐个识别,只有一个就直接向我要视频描述并按上面第 3 步的流程(提交任务 → 轮询 → 下载 → 发我)跑完全程,期间不要向我提问;多个就先告诉我「默认模型是 XX,本机还有 XX 和 XX,请选择使用哪个模型」,等我确认后再继续此流程。
5. 如果我说「再接入一个 ClawPower 视频模型,文档链接:YY」,把新模型追加到全局记忆,默认模型保持不变;如果我说「把默认视频模型改成 YY」,就打开新链接识别模型名并更新默认。两种情况都不需要重新问我要 Key。

现在开始第 1 步,先向我要这两项信息。
发送后 Agent 会先向你要两样东西:
- 文档链接:在下表选择要用的模型,点右侧「复制」按钮,将完整 URL 发给 Agent。其他模型的文档可从左侧「视频模型」菜单打开。
- Key:把「图像视频精选」分组下的 Key 发给它。
| 文档地址(点右侧按钮一键复制完整链接) |
|---|
查询视频任务接口不用你单独发
视频是异步生成的——但你不需要为它单独再复制一个链接发过去。上面那段视频提示词的第 2 步里,已经包含了 ClawPower 的「查询视频任务」接口地址(https://docs.clawpowerai.com/api/tasks/query-video-task)。Agent 收到后会自己打开它学习查询节奏,照着调用即可。
两项都给它之后,它会向你要视频描述,然后开始生成(提交任务 → 轮询 → 下载视频 → 发回)。
操作演示
下面以 WorkBuddy 生成图像为例,演示如何完成第一次配置,再让它帮你生成图片。
第 1 步:复制提示词,发送给 WorkBuddy
找到本页上方的「示例 1:教会 Agent 生成图像」,点击代码框右上角的复制按钮,即可一键复制全部提示词。然后粘贴到 WorkBuddy 的输入框中并发送。
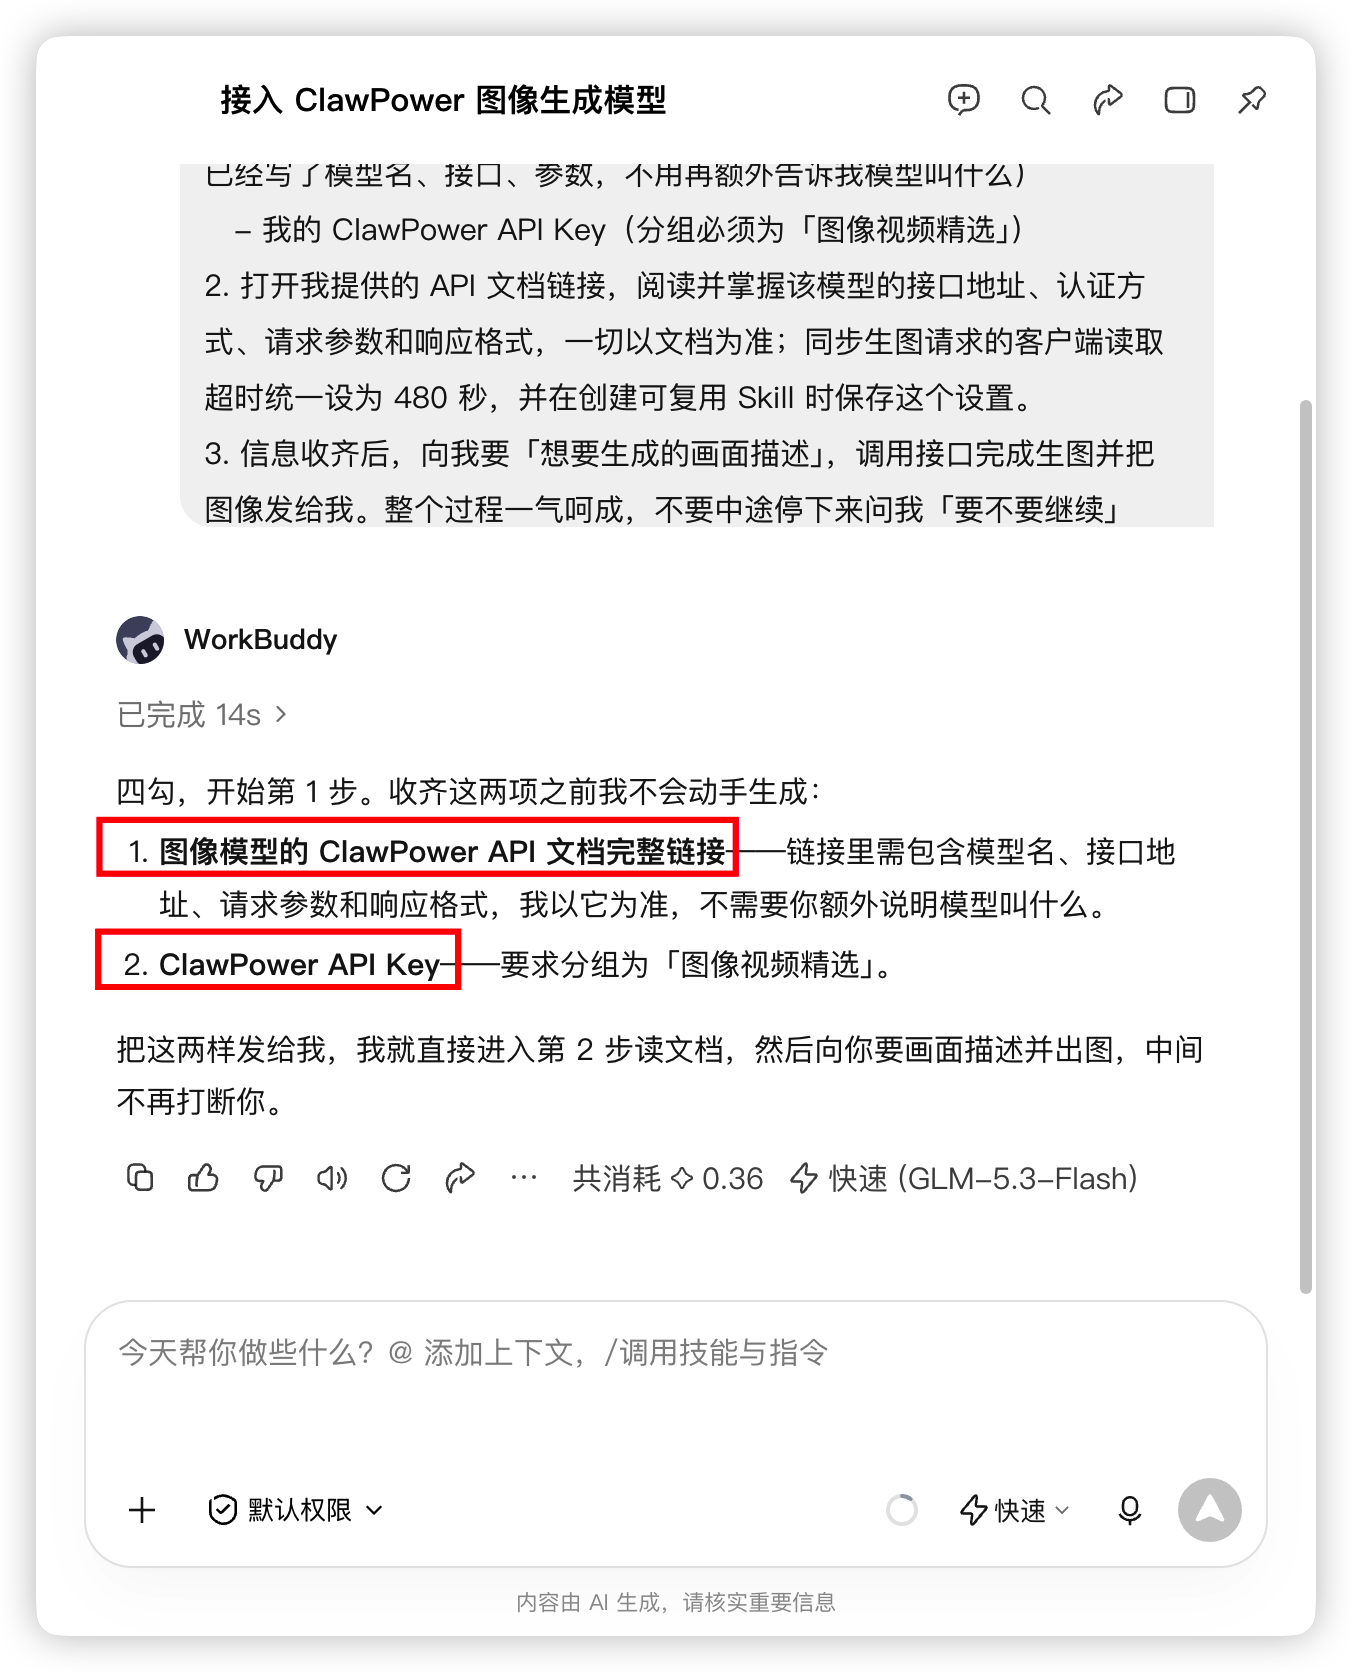
WorkBuddy 收到后,会向你索取两项信息:
- 你想使用的图像模型的 ClawPower API 文档完整链接。
- 你的 ClawPower API Key,分组须为「图像视频精选」。
第 2 步:找到模型的 API 文档链接
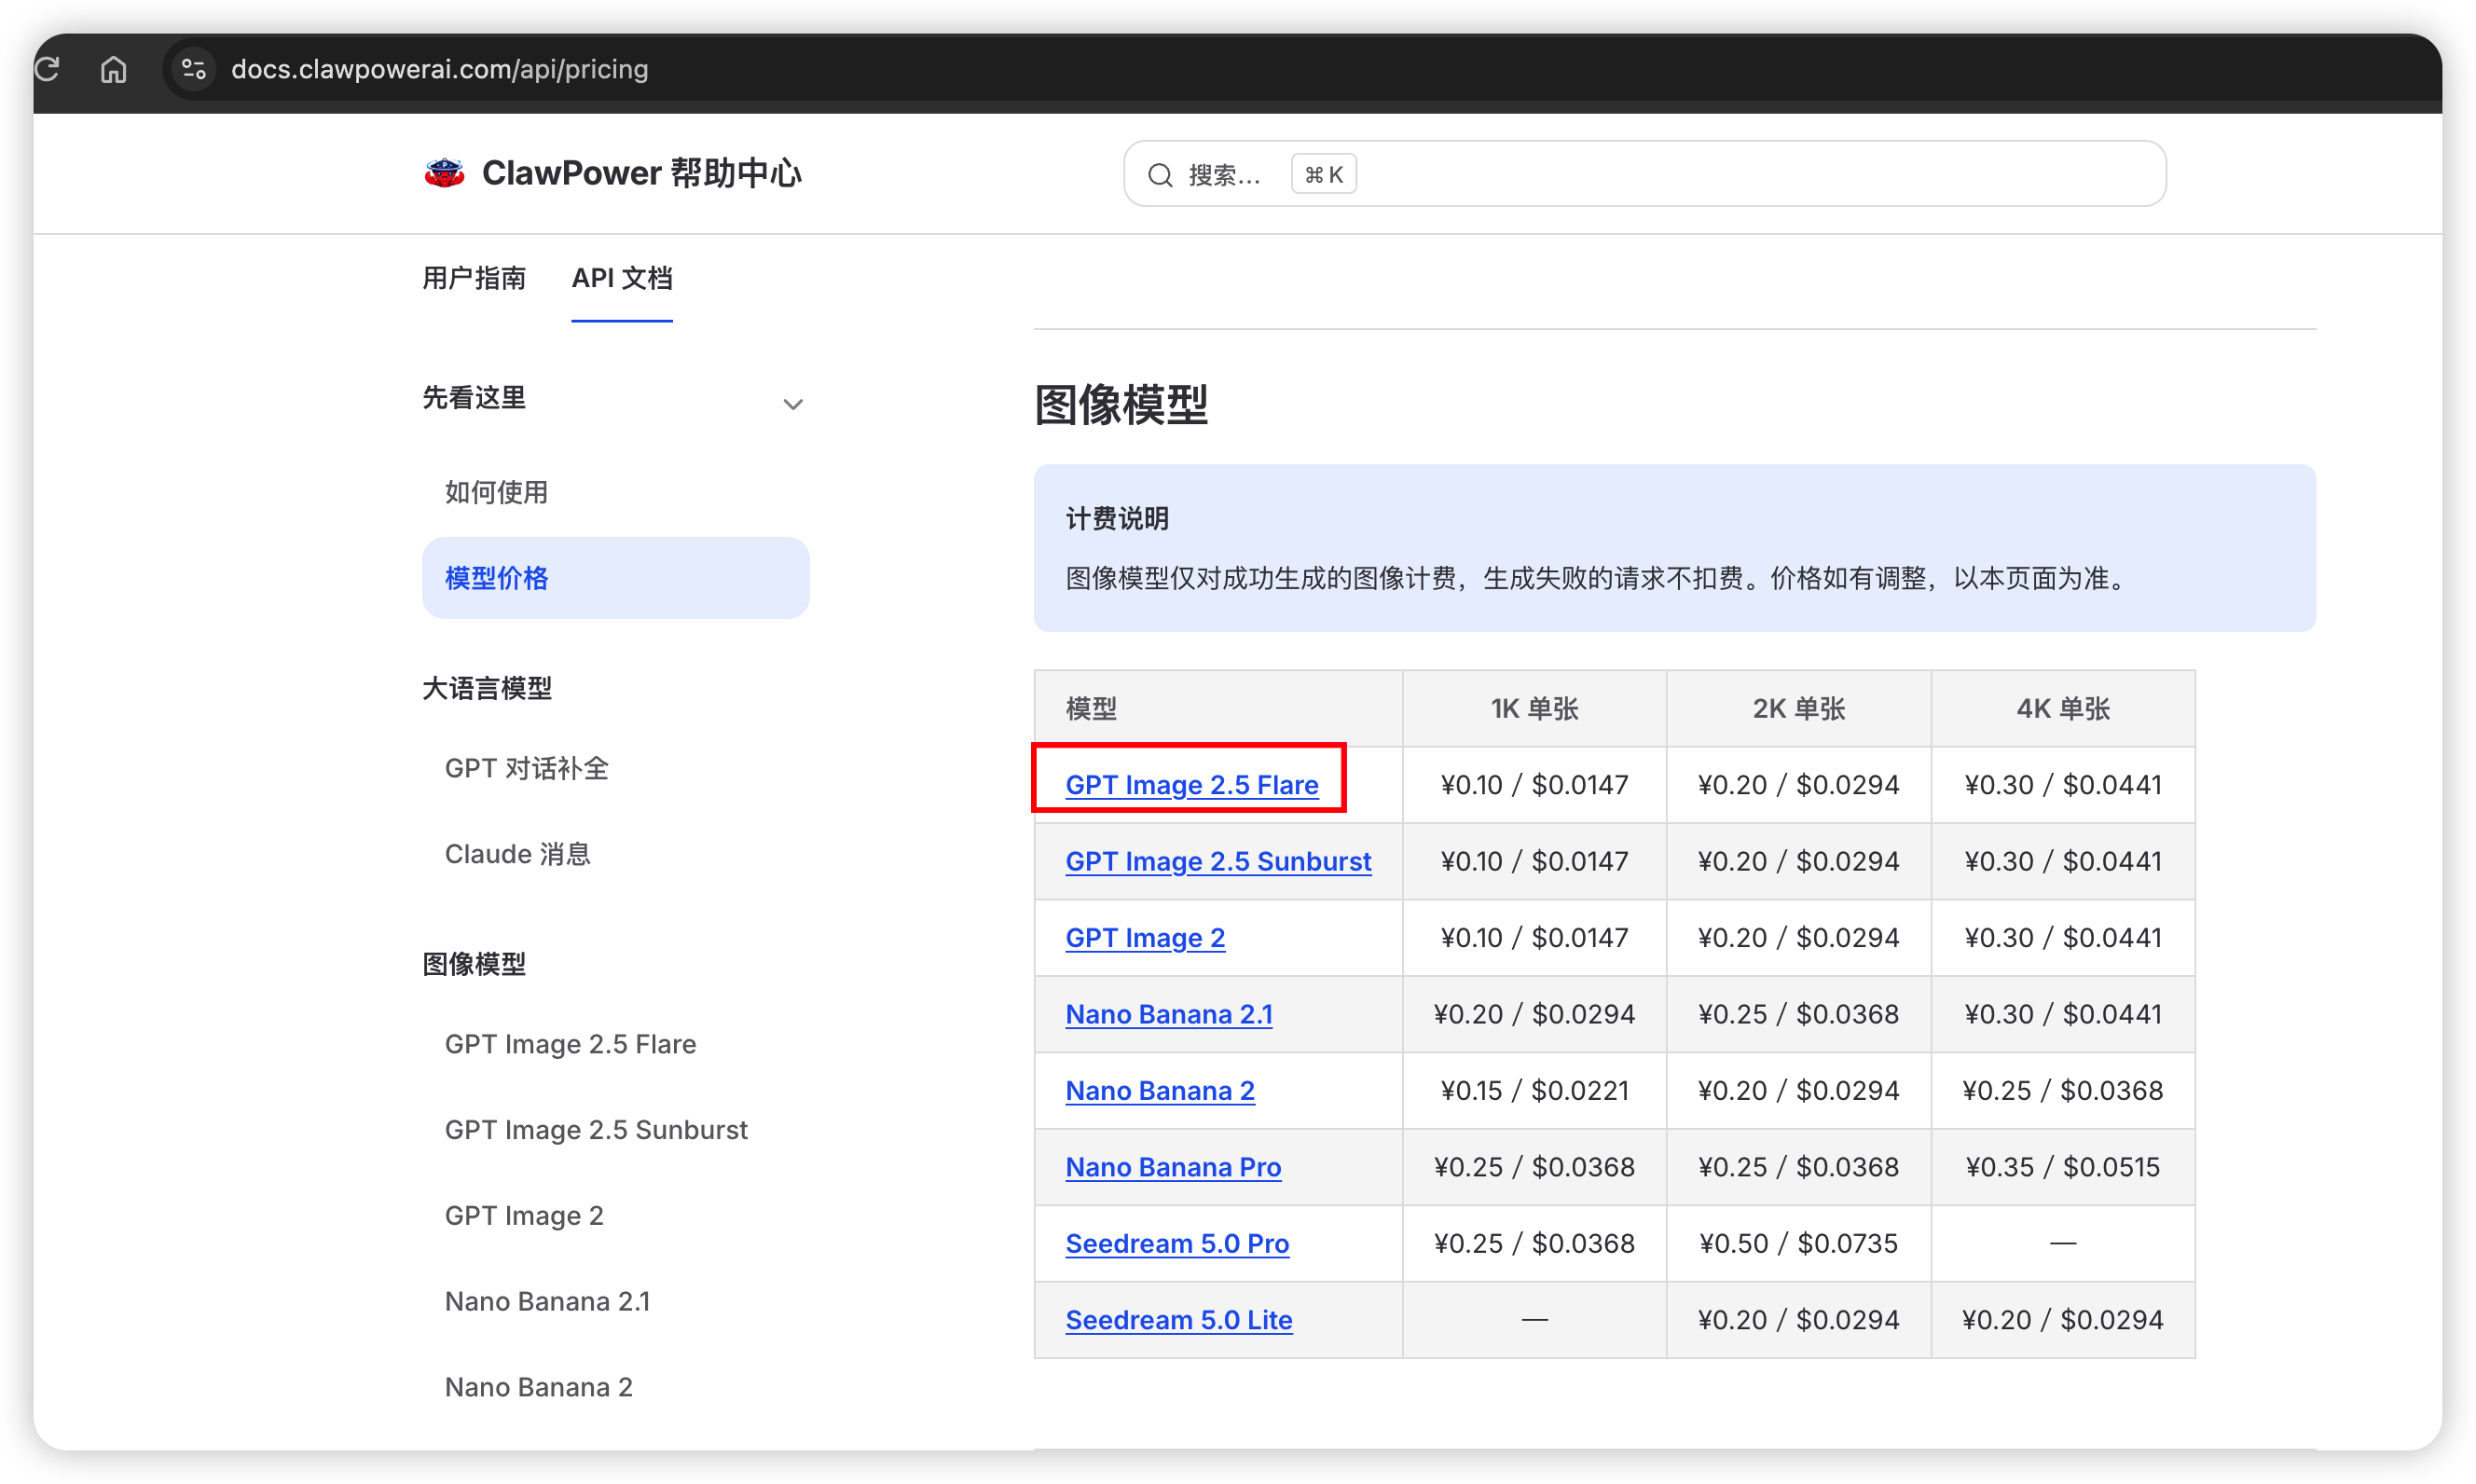
打开模型价格页面,在「图像模型」中找到想使用的模型。这里以 GPT Image 2.5 Flare 为例,点击模型名称,进入对应的 API 文档。
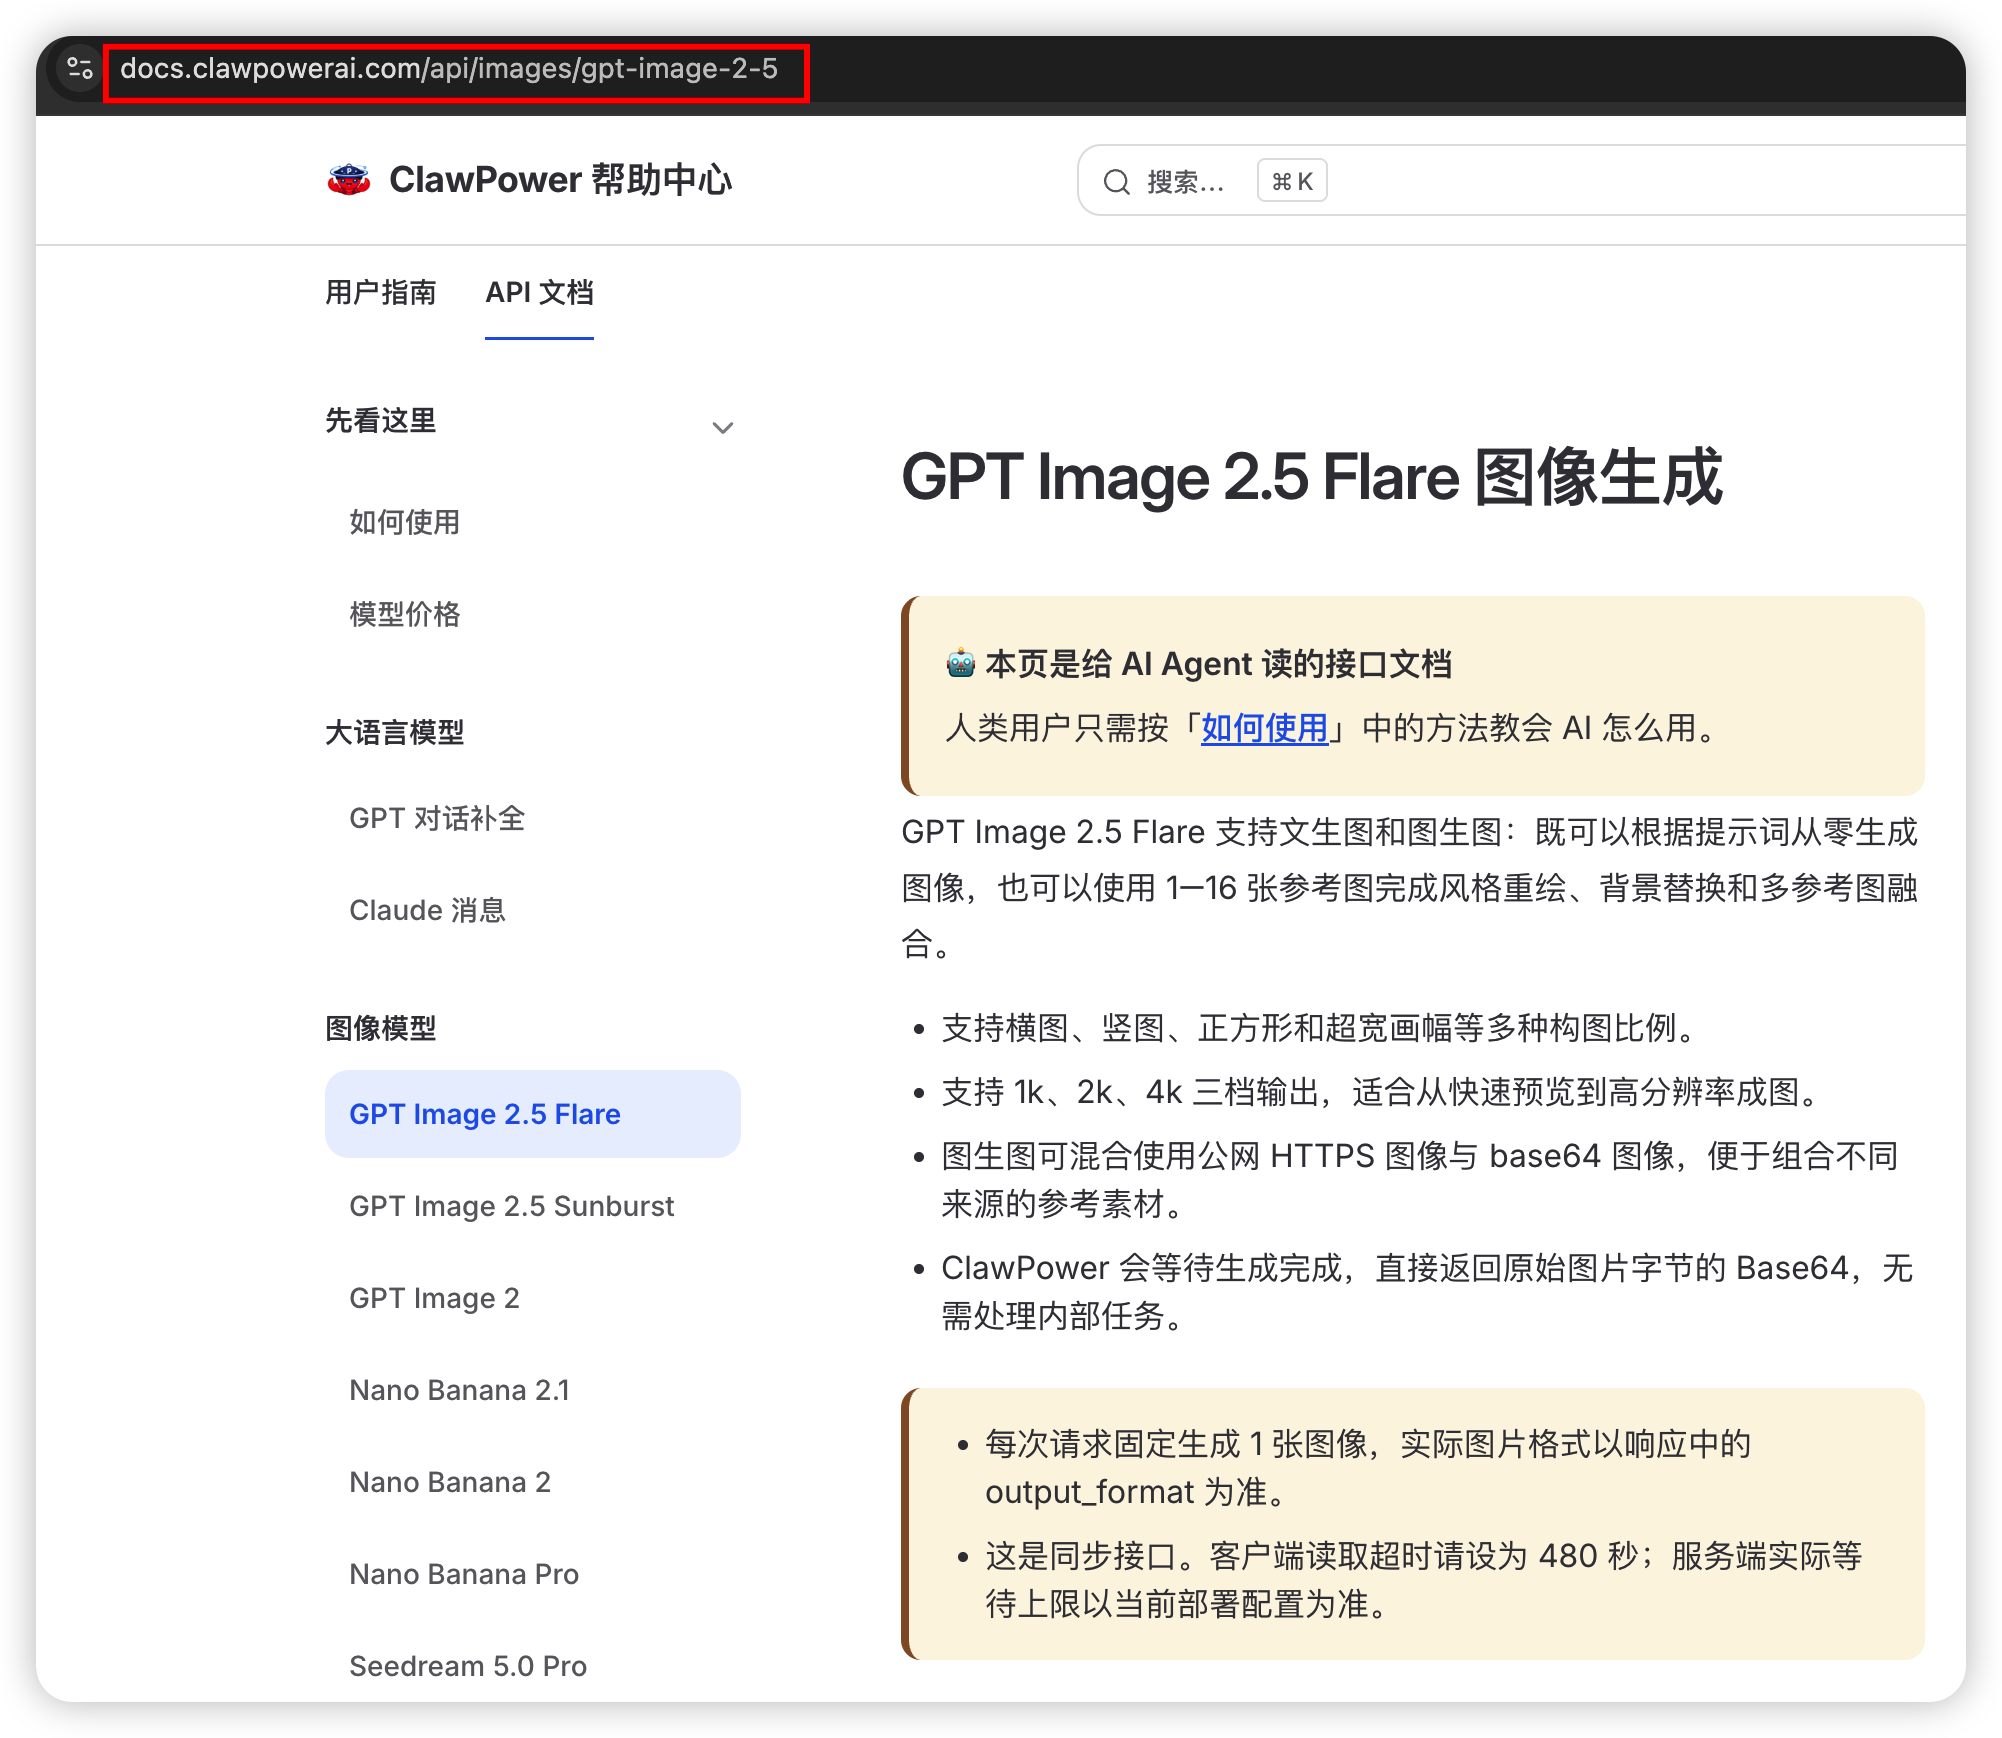
进入模型文档后,复制浏览器顶部地址栏里的完整网址。这就是 WorkBuddy 要的第 1 项信息。
第 3 步:创建并复制 API Key
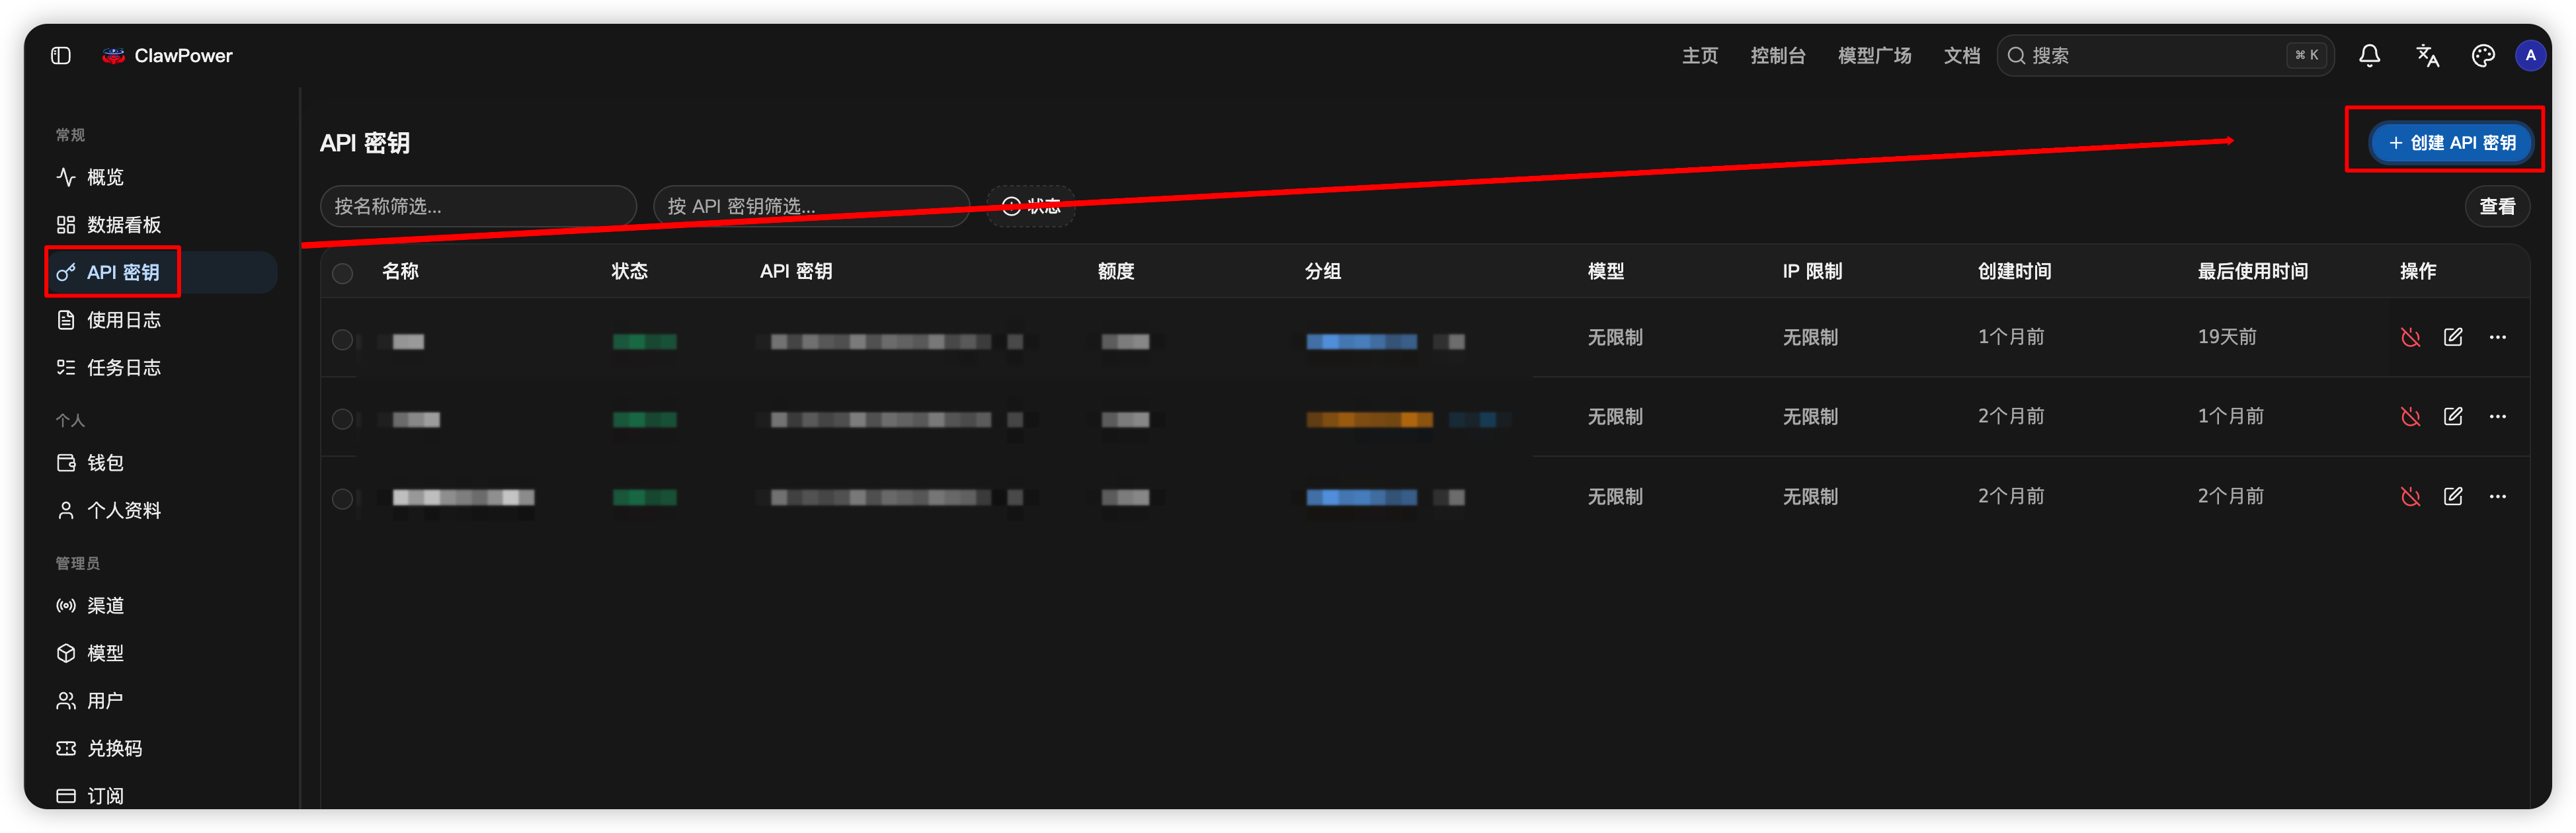
打开 API 密钥页面,点击右上角的「创建 API 密钥」。
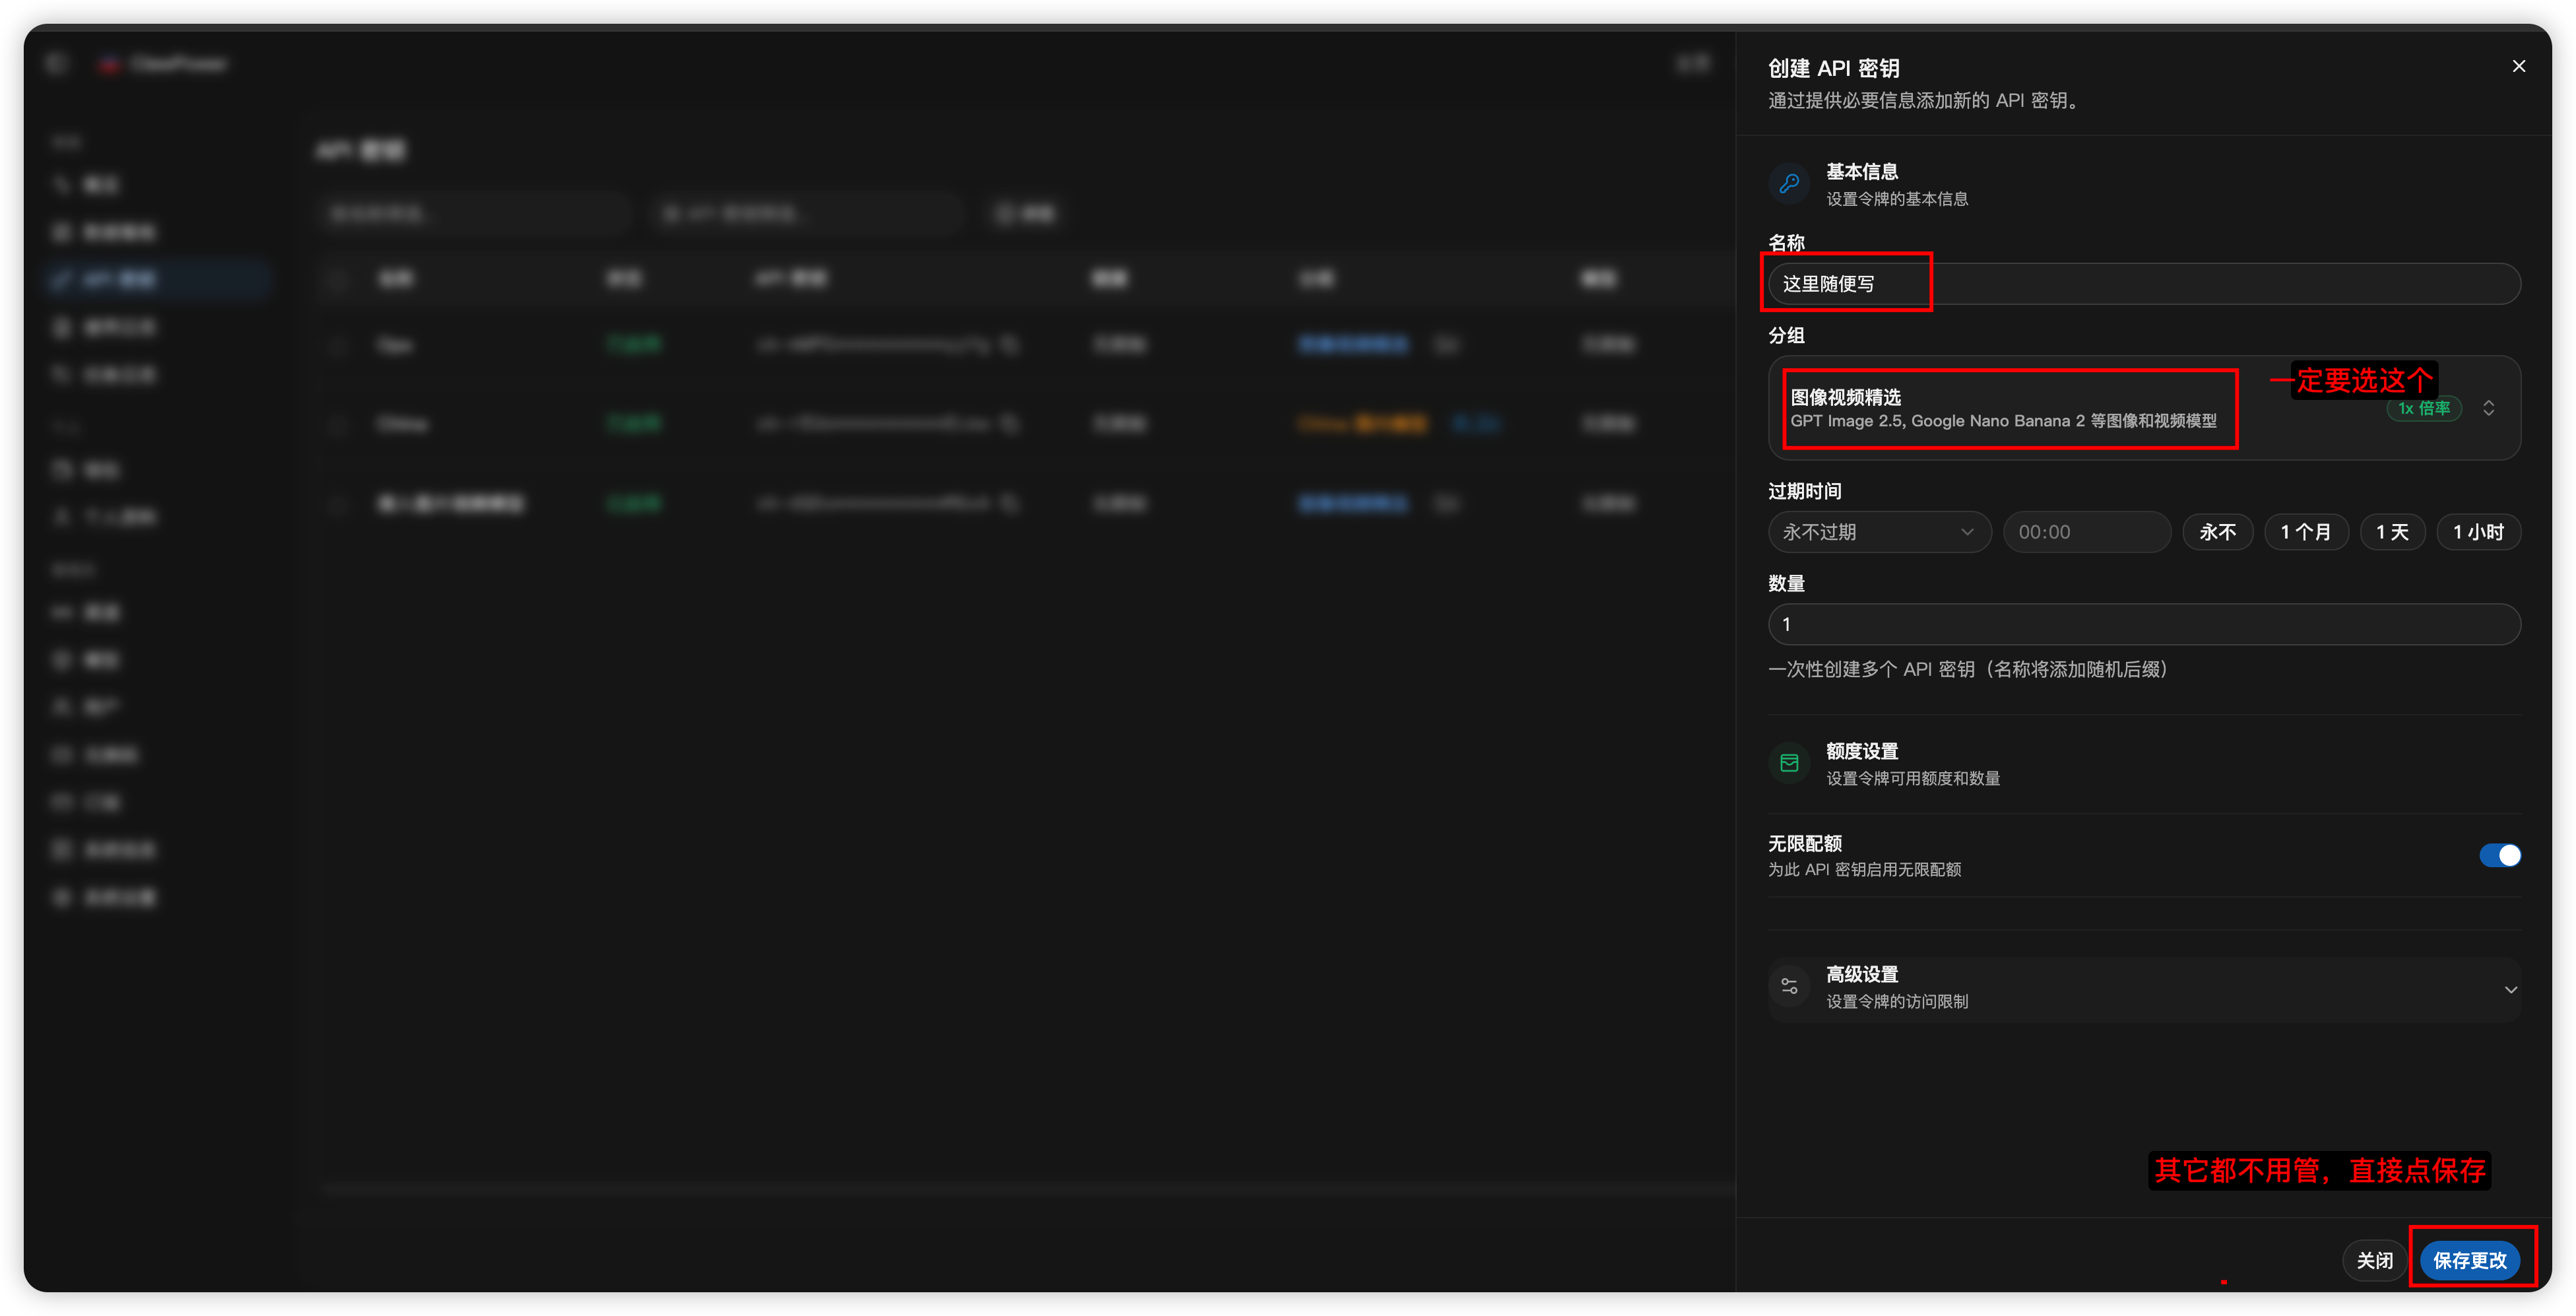
填写名称,分组一定选择「图像视频精选」,其余设置保持默认,然后点击「保存更改」。
创建完成后,回到「API 密钥」列表,复制刚创建的 API Key。这就是 WorkBuddy 要的第 2 项信息。如果已经有「图像视频精选」分组的 API Key,可以直接复制使用。
第 4 步:把文档链接和 Key 一起发给 WorkBuddy
回到 WorkBuddy,把刚才复制的两项信息一起粘贴并发送:第一行是模型的 API 文档链接,第二行是你自己的 API Key。
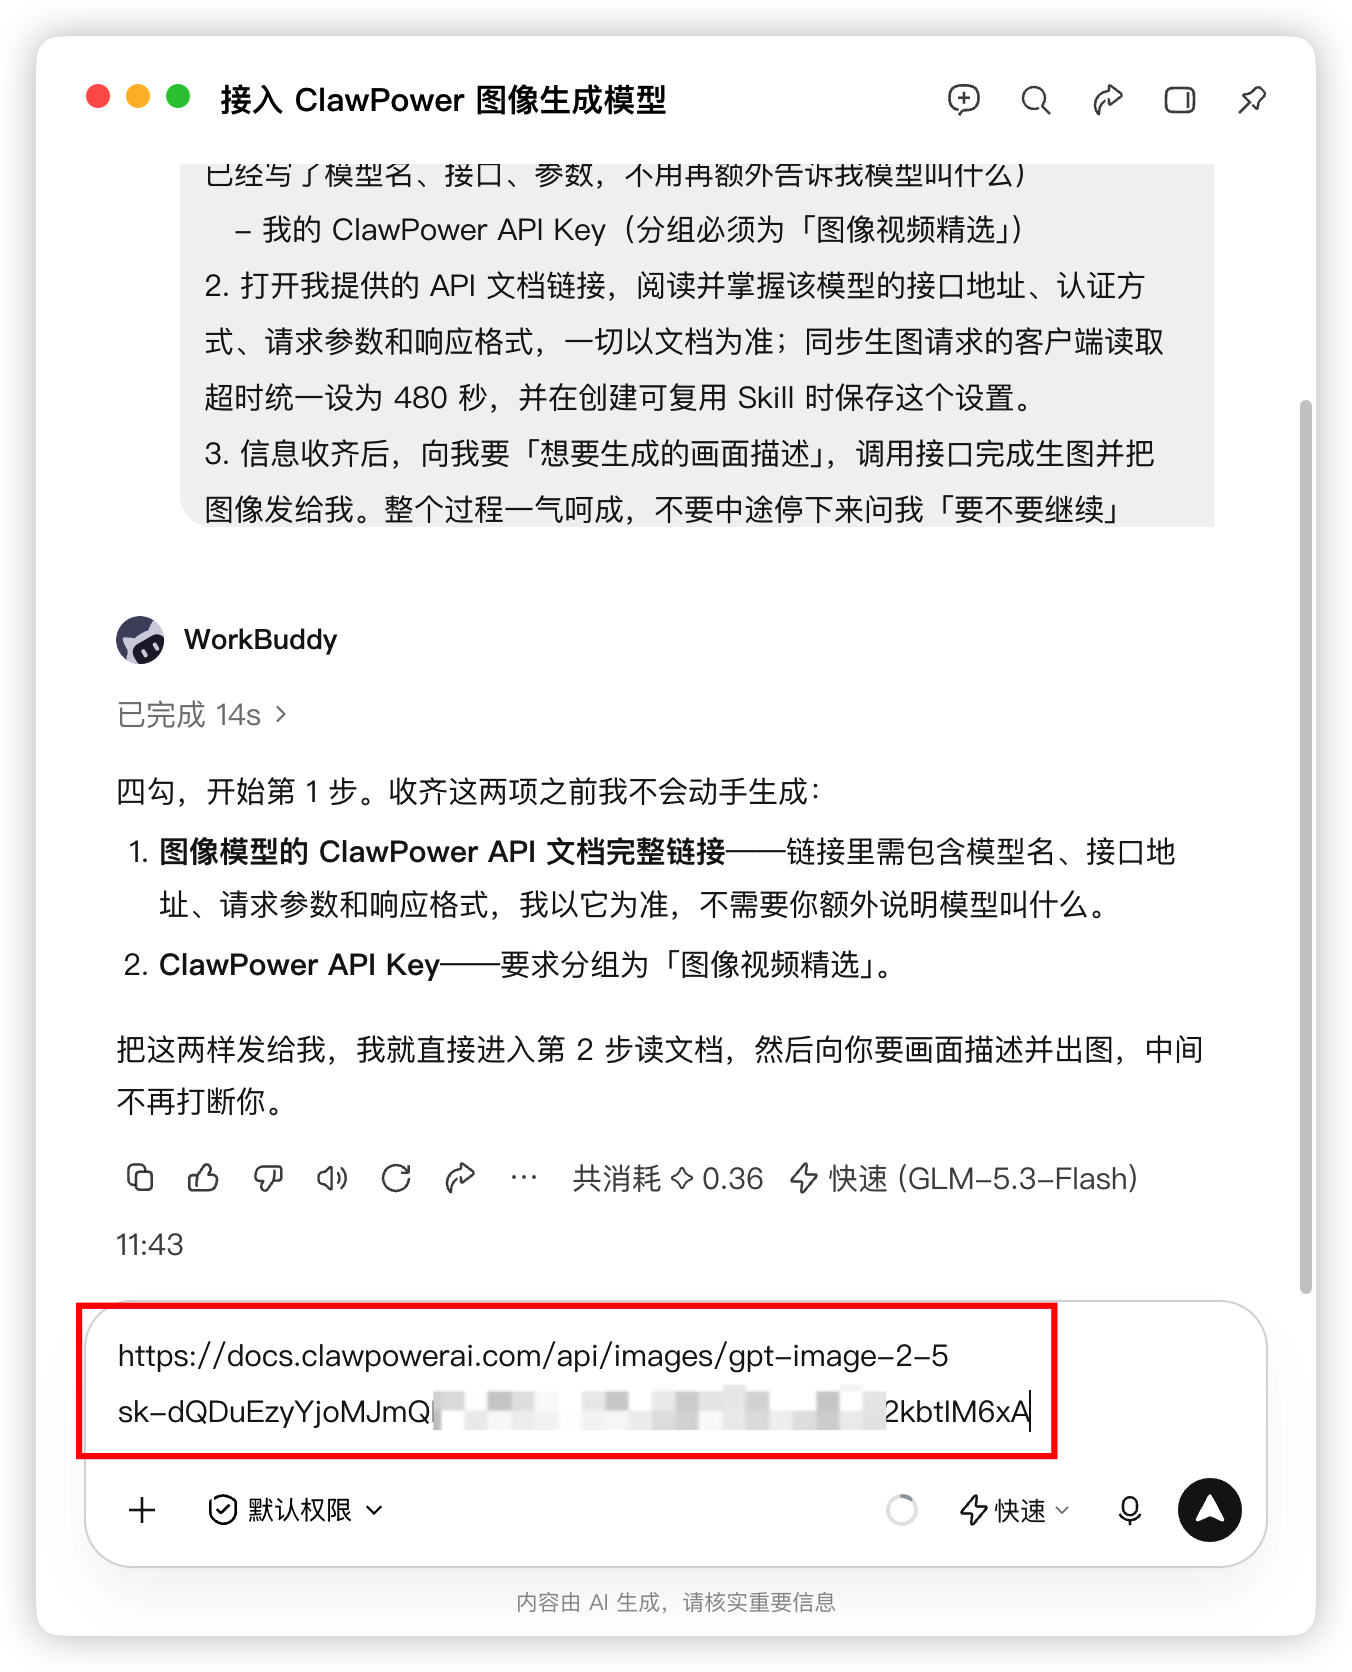
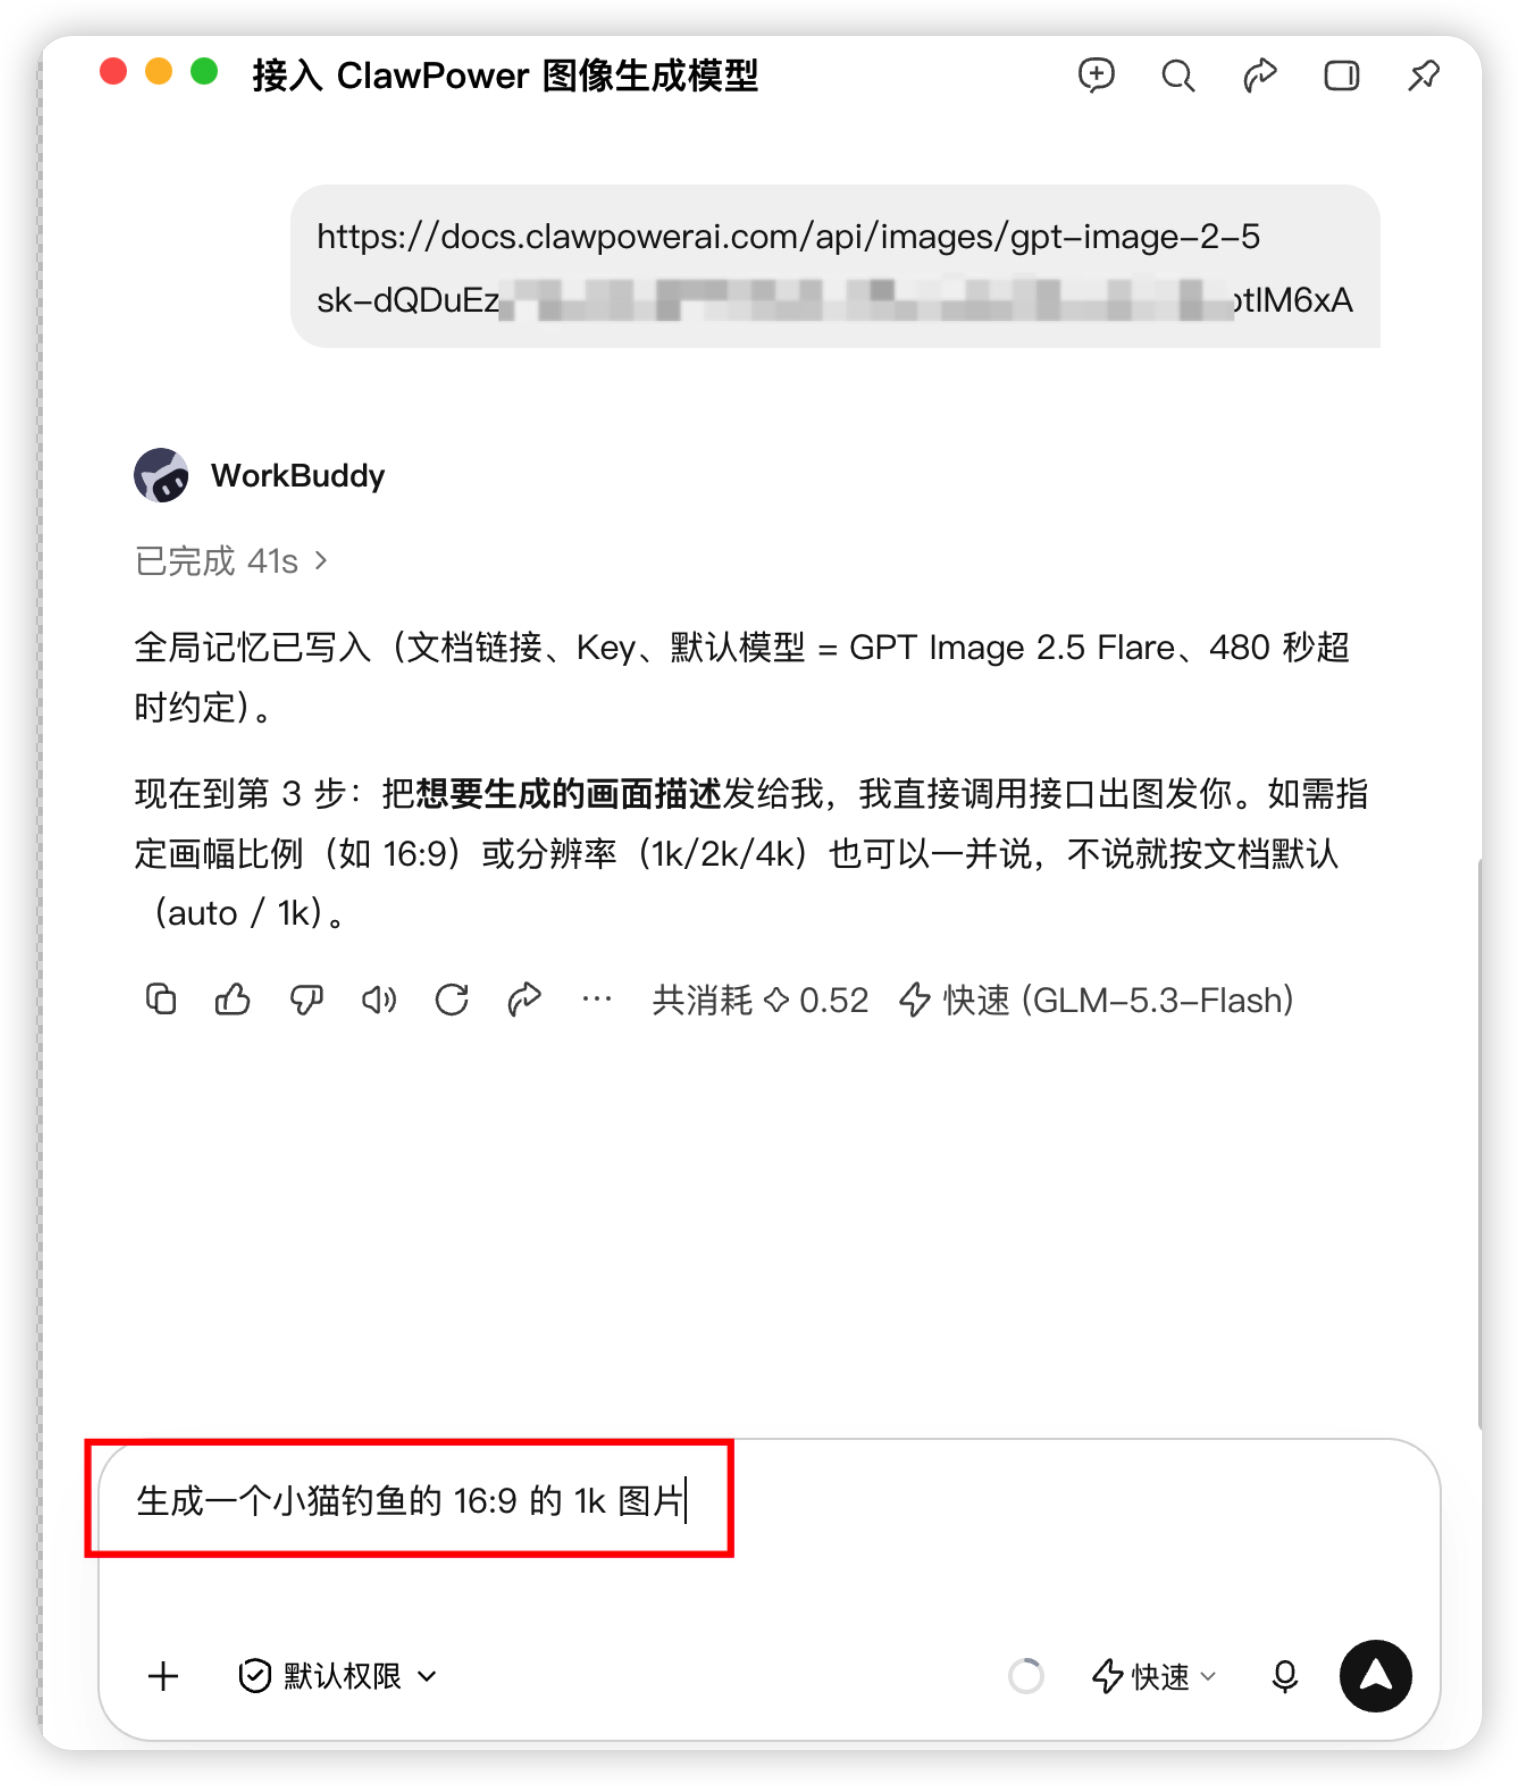
第 5 步:告诉它想生成什么图片
等待 WorkBuddy 完成配置并向你询问画面描述,然后直接告诉它想生成的内容。你也可以一起指定图片比例和分辨率:
- 图片比例:想生成正方形图片,就告诉它比例为
1:1;也可以指定横图16:9、竖图9:16等比例。本例模型未指定比例时使用auto。 - 分辨率:本例模型支持
1K、2K、4K。
例如,发送:
text
生成一张小猫钓鱼的图片,比例 16:9,分辨率 1K。发送后,等待 WorkBuddy 完成生成并把图片发回来。
一次性配置 + 全自动执行
发送完上面任一段提示词后,正常的运行流程是这样的:
- Agent 向你要文档链接和Key;
- 你各发一份给它;
- Agent 自动记住配置并问你画面描述 / 视频描述;
- 你发一句描述(如「夕阳下的雪山,8K,电影感」);
- Agent 自动完成生成 + 异步轮询 + 下载 + 发回给你。
整个过程你不需要再发任何消息,Agent 也不会在轮询期间反复问你「要不要继续」「是否要等」——它会按文档节奏一直查询到成功(或在文档建议的最大次数内失败),只在最后把结果或失败原因一次性发给你。这就是「发一次配置教程,之后全程不用再管」的目标。
下次使用时如何唤醒
第一次配置完成后,下次使用有两种唤醒方式,不需要重新发送上面的提示词,也不需要再发一次 Key。
方式一:用斜杠选择 Skill
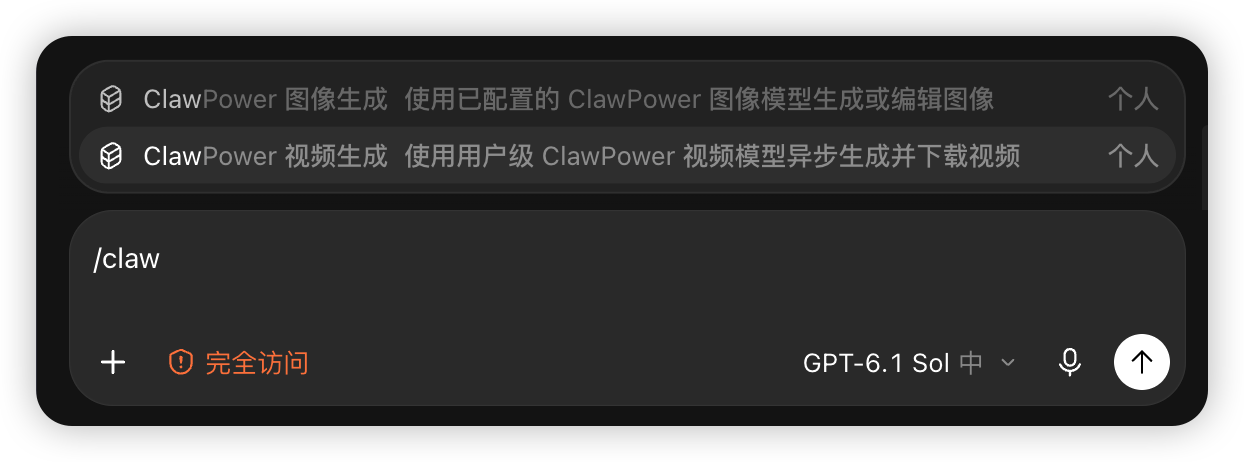
如果 Agent 已将配置保存为可复用 Skill,并且支持斜杠菜单,可以在对话框中输入 /claw,再从弹出的列表中选择:
- ClawPower 图像生成:生成或编辑图像。
- ClawPower 视频生成:生成视频。
选中对应 Skill 后,再告诉它想生成的内容即可。
方式二:直接在对话框里说
也可以直接在对话框中发送:
- 用 ClawPower 生成图像。
- 用 ClawPower 生成视频。
Agent 会读取已保存的模型配置:只有一个模型时直接使用;有多个模型时,先告诉你默认模型和其他可选模型,等你选择后再继续。随后告诉它想生成的画面或视频内容即可。
例如,直接发送「用 ClawPower 生成一张小猫钓鱼的图像」:
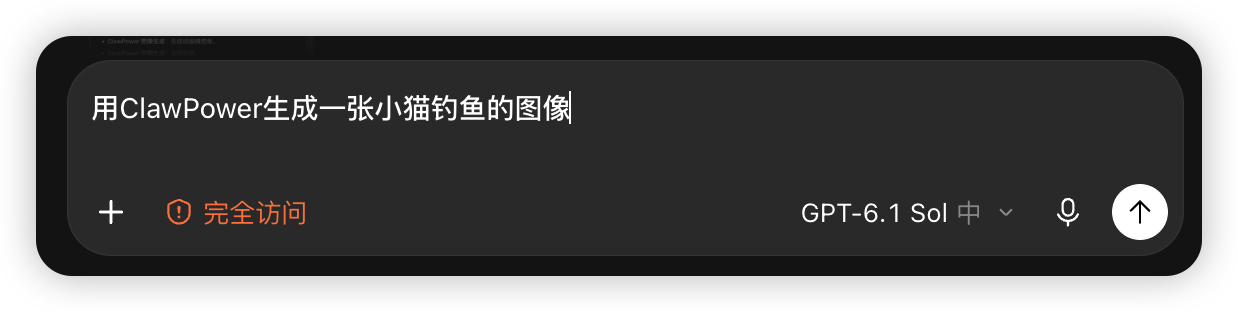
唤醒词要带上「ClawPower」。如果只说「生成图像」,Agent 可能会调用它自己的内置模型。
有多个模型时怎么选
唤醒时 Agent 会先打开全局记忆里记的全部图像 / 视频模型文档链接逐一识别:只有一个就直接用;多个就先汇报默认那个 + 其他可选列表,等你确认后再继续。
想往记忆里再添加一个模型,复制下面这条发给 Agent:
text
再接入一个 ClawPower 图像模型,文档链接:https://docs.clawpowerai.com/api/images/nano-banana-2想接入其他模型,把这条消息里的 URL 换成在左侧菜单找到的对应文档地址即可——不用一行一行复制本页面列出的每一个模型。视频模型同理,把「图像」换成「视频」。Agent 收到后会自己打开链接识别模型名再加入列表,默认模型不变。
把某个模型设为默认,对 Agent 说「把默认图像模型改成 Nano Banana 2」即可。
让一台电脑的所有项目共用
上面两个提示词是纯文本指令,保存在哪里,就决定了它生效的范围:
- 只贴在对话里 —— 只对当前这个会话有效;
- 存进 Agent 的全局记忆 / 全局配置文件 —— 同一台电脑上的所有项目都生效,只需教一次。
常用 Agent 的全局配置文件位置:
| Agent | 全局配置文件 |
|---|---|
| Claude Code | ~/.claude/CLAUDE.md |
| Codex | ~/.codex/AGENTS.md |
| Gemini CLI | ~/.gemini/GEMINI.md |
两种做法任选其一:
- 让 Agent 自己存:示例提示词第 4 步已经要求它写入全局记忆,第一次发送时它就会自动完成,其他项目无需再做任何事;
- 手动保存:把示例提示词原文追加到上表中你所用 Agent 对应文件的末尾,再把模型文档地址与 Key 一并写进去,保存即可。
关于 Key 的存放
写入全局配置后,Key 会以明文保存在本机文件中。请确认这台电脑只由你本人使用;如需更换 Key,重新创建 API 密钥并更新配置文件即可。